tc netem permet de faire en sorte qu’un hôte Linux en parfaite santé se comporte comme s’il était au bout d’un lien transatlantique congestionné : délai fixe, gigue, perte aléatoire de paquets, duplication, déséquencement ou plafond de débit, en une seule commande, sans installer quoi que ce soit. Le piège qui attrape presque tout le monde au premier essai touche le sens et la portée. netem est une discipline de file d’attente posée sur le chemin de sortie d’une interface : il ne façonne donc que les paquets qui quittent cette interface — et l’attacher à la racine de l’interface qui porte votre session SSH dégrade votre propre canal de contrôle en même temps que le trafic que vous vouliez tester. Ce guide couvre les options de délai, de perte et de débit qui se comportent de façon prévisible, la recette de filtre qui limite les dégâts à une seule destination, et la façon de prouver que le façonnage est bel et bien actif.
Ce que vous allez accomplir
- Inspecter la qdisc déjà attachée à une interface avant d’y toucher, et la remettre proprement en place après.
- Ajouter un délai avec une gigue et une corrélation réalistes, de la perte aléatoire, et un plafond de bande passante — séparément puis combinés.
- Restreindre netem à une seule adresse de destination avec un filtre
prioouhtb, pour que votre session SSH et votre supervision restent intactes. - Valider l’effet de bout en bout avec
ping, les compteurs detc -s qdisc showet une mesure de débit ou de temps de réponse. - Reconnaître les pannes réseau que netem sait reproduire et celles qui lui échappent.
Prérequis
- Un noyau Linux où le module
sch_netemest disponible, plusiproute2pour le binairetc. Les deux existent dans toutes les distributions courantes :apt install iproute2sur Debian et Ubuntu,dnf install iproute-tcsur la famille RHEL (Red Hat sorttcdu paquetiproutede base, ce qui surprend beaucoup de monde sur les images minimales). - Root, ou un processus doté de la capacité
CAP_NET_ADMIN. Toutes les commandes ci-dessous sont écrites avecsudo. - Les images de conteneurs sont un blocage fréquent. Les images minimales n’embarquent souvent aucun
tc, et un conteneur non privilégié ne peut pas modifier les qdiscs de l’hôte même si le binaire est présent. - Sachez à partir de quelle version chaque option existe.
netem rateest disponible depuis Linux 3.3 etslotdepuis 4.15. Si un mot-clé est rejeté comme inconnu, votretcen espace utilisateur est plus vieux que la syntaxe que vous avez copiée. - Fortement recommandé : faites vos premiers essais dans un espace de noms réseau ou une machine virtuelle jetable, pas sur un hôte que vous joignez par le réseau. Une paire veth dans
ip netnsvous donne un lien que vous pouvez démolir sans conséquence :
sudo ip netns add lab
sudo ip link add veth-host type veth peer name veth-lab
sudo ip link set veth-lab netns lab
Comment ça fonctionne
Chaque interface Linux possède une discipline de file d’attente — une qdisc — placée entre la pile IP et la file de transmission du pilote. Les paquets y sont mis en file au moment de sortir, puis retirés quand le pilote est prêt. Une qdisc peut retarder, jeter, réordonner ou limiter le débit de tout ce qui la traverse, et netem n’est rien d’autre qu’une qdisc qui fait ces choses volontairement.
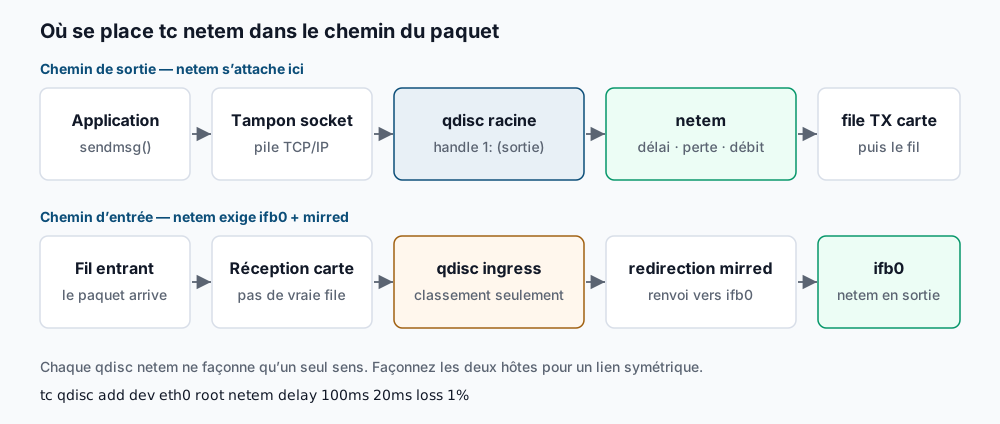
Deux conséquences structurelles découlent de cette position dans la pile.
netem n’agit qu’en sortie. Il n’existe pas de vraie file du côté réception : quand le noyau voit le paquet, celui-ci a déjà traversé le fil, il n’y a donc plus rien à retarder. Une qdisc ingress existe, mais elle ne sait que classer et contrôler le débit, pas ajouter de latence. Pour façonner le trafic entrant, vous le redirigez vers un périphérique intermédiaire de type ifb avec mirred, puis vous attachez netem à la sortie de ce périphérique :
sudo modprobe ifb
sudo ip link set ifb0 up
sudo tc qdisc add dev eth0 handle ffff: ingress
sudo tc filter add dev eth0 parent ffff: protocol ip u32 match u32 0 0 \
  action mirred egress redirect dev ifb0
sudo tc qdisc add dev ifb0 root netem delay 80ms
Les handles et la hiérarchie comptent. Une qdisc s’attache soit à root — le sommet du chemin de sortie, où elle voit chaque paquet sortant — soit comme enfant d’une classe dans une qdisc à classes comme prio ou htb. Attacher netem à root tient en une commande et façonne tout, y compris vos réponses SSH. L’attacher sous une classe fait que seul le trafic que vos filtres dirigent vers cette classe est dégradé. Presque tous les tests réels veulent la seconde forme.
Autre point à bien intégrer : un délai appliqué sur un hôte n’affecte qu’un seul sens. ping rapporte le temps aller-retour, soit la somme des deux sens, donc 100 ms de délai en sortie sur un seul hôte augmente le temps aller-retour d’environ 100 ms, pas de 200 ms. Une perte configurée sur les deux hôtes se cumule au lieu de se moyenner.
Pas à pas
1. Inspectez ce qui est déjà attaché. Ne présumez jamais que l’interface est nue. Les distributions récentes installent fq_codel, fq ou mq par défaut, et vous devez savoir quoi remettre.
sudo tc qdisc show dev eth0Sortie attendue sur un hôte Ubuntu typique :
qdisc fq_codel 0: root refcnt 2 limit 10240p flows 1024 quantum 1514 target 5ms interval 100ms memory_limit 32Mb ecn drop_batch 64Notez cette ligne quelque part. Si vous voyez plutôt qdisc noqueue 0: root refcnt 2, l’interface n’a aucune qdisc configurable — chose courante sur les périphériques virtuels et les ponts ; vous pouvez en ajouter une, mais il n’y a rien à restaurer.
2. Armez un coupe-circuit avant de toucher à un hôte distant. Si le façonnage tourne mal, vous voulez que la machine se répare toute seule. Lancez un démontage détaché avant la première modification.
sudo sh -c 'sleep 300; tc qdisc del dev eth0 root' &Le shell affiche un numéro de tâche du genre [1] 41822. Cinq minutes plus tard, la qdisc est retirée, que votre session ait survécu ou non. Annulez avec sudo pkill -f 'sleep 300' quand c’est terminé, et réarmez au besoin.
3. Ajoutez un délai fixe. Le cas utile le plus simple : chaque paquet sortant attend 100 ms.
sudo tc qdisc add dev eth0 root netem delay 100msLe succès est silencieux : tc n’affiche rien quand l’ajout réussit. Vérifiez avec sudo tc qdisc show dev eth0, qui rapporte maintenant :
qdisc netem 8001: root refcnt 2 limit 1000 delay 100msLe handle 8001: a été attribué automatiquement. limit 1000 est le propre arriéré de netem, en paquets ; avec un délai élevé et un débit élevé, vous pouvez l’atteindre et commencer à jeter des paquets sans le vouloir, alors montez-le avec limit 10000 pour un tuyau large et lent.
4. Ajoutez de la gigue et de la corrélation. Un délai constant n’est pas réaliste : les vrais liens varient. La deuxième valeur est l’amplitude de la gigue, la troisième est la corrélation entre paquets consécutifs, en pourcentage.
sudo tc qdisc change dev eth0 root netem delay 100ms 20ms 25%Le délai est désormais réparti uniformément entre 80 ms et 120 ms, chaque paquet étant corrélé à 25 % au précédent. Pour une distribution en cloche plus proche du comportement réel d’un lien étendu, ajoutez une table de distribution :
sudo tc qdisc change dev eth0 root netem delay 100ms 20ms distribution normalsudo tc qdisc show dev eth0 reflète le changement :
qdisc netem 8001: root refcnt 2 limit 1000 delay 100ms 20msLes deux espaces devant la valeur de gigue sont normaux dans la sortie de tc, pas une erreur de mise en forme.
5. Ajoutez de la perte de paquets. La perte s’exprime en pourcentage, avec une corrélation facultative pour produire des rafales plutôt que des pertes réparties uniformément.
sudo tc qdisc change dev eth0 root netem loss 3% 25%Attention aux ordres de grandeur. 1 % de perte suffit à faire s’effondrer le débit TCP sur un long chemin ; 30 % fait expirer la plupart des protocoles applicatifs au lieu de les dégrader, ce qui ne vous apprend rien d’utile. Partez de 0,5 % et montez progressivement.
6. Combinez délai, perte et déséquencement dans une seule qdisc. Tous les paramètres netem vivent sur la même qdisc : il faut donc les donner ensemble — un second change qui ne mentionne que loss efface silencieusement le délai posé plus tôt.
sudo tc qdisc change dev eth0 root netem delay 120ms 30ms distribution normal \
  loss 1% 25% duplicate 0.1% reorder 2% 50%
Relisez la ligne résultante au complet :
sudo tc qdisc show dev eth0qdisc netem 8001: root refcnt 2 limit 1000 delay 120ms 30ms loss 1% 25% duplicate 0.1% reorder 2% 50% gap 17. Plafonnez la bande passante. netem a son propre paramètre rate, la façon la plus simple de combiner un tuyau lent et de la latence :
sudo tc qdisc change dev eth0 root netem delay 40ms rate 5mbitQuand vous voulez un vrai seau à jetons avec une rafale configurable, empilez tbf comme parent et suspendez netem en dessous :
sudo tc qdisc del dev eth0 root
sudo tc qdisc add dev eth0 root handle 1: tbf rate 5mbit burst 32kbit latency 400ms
sudo tc qdisc add dev eth0 parent 1:1 handle 10: netem delay 40ms 8ms
sudo tc qdisc show dev eth0 devrait maintenant lister les deux étages :
qdisc tbf 1: root refcnt 2 rate 5Mbit burst 4Kb lat 400ms
qdisc netem 10: parent 1:1 limit 1000 delay 40ms  8ms
8. Distinguez add, change et replace. add crée une qdisc et échoue si une autre occupe déjà cette position. change modifie les paramètres d’une qdisc existante en conservant son handle et son arriéré. replace la remplace, et la crée si elle est absente — le choix idempotent pour un script :
sudo tc qdisc replace dev eth0 root netem delay 60ms loss 0.5%9. Restreignez le façonnage à une seule destination. C’est l’étape qui vous garde connecté. Utilisez une qdisc racine prio, attachez netem à la bande 3 seulement, et n’y dirigez que la destination de test. Tout le reste — SSH, supervision, mises à jour de paquets — continue de circuler par les bandes non façonnées.
sudo tc qdisc del dev eth0 root
sudo tc qdisc add dev eth0 root handle 1: prio
sudo tc qdisc add dev eth0 parent 1:3 handle 30: netem delay 150ms 30ms loss 2%
sudo tc filter add dev eth0 protocol ip parent 1:0 prio 3 u32 \
  match ip dst 203.0.113.45/32 flowid 1:3
Vérifiez que le filtre est bien posé :
sudo tc filter show dev eth0filter parent 1: protocol ip pref 3 u32 chain 0
filter parent 1: protocol ip pref 3 u32 chain 0 fh 800: ht divisor 1
filter parent 1: protocol ip pref 3 u32 chain 0 fh 800::800 order 2048 key ht 800 bkt 0 flowid 1:3 not_in_hw
match cb00712d/ffffffff at 16Pour cibler encore plus finement un seul service, ajoutez le port de destination — par exemple TCP 443 :
sudo tc filter add dev eth0 protocol ip parent 1:0 prio 2 u32 \
  match ip dst 203.0.113.45/32 match ip dport 443 0xffff flowid 1:3
L’équivalent avec htb vous donne en plus une classe de débit par destination :
sudo tc qdisc add dev eth0 root handle 1: htb default 10
sudo tc class add dev eth0 parent 1: classid 1:10 htb rate 1000mbit
sudo tc class add dev eth0 parent 1: classid 1:20 htb rate 10mbit
sudo tc qdisc add dev eth0 parent 1:20 handle 20: netem delay 150ms 30ms
sudo tc filter add dev eth0 protocol ip parent 1:0 prio 1 u32 \
  match ip dst 203.0.113.45/32 flowid 1:20
10. Démontez tout. Retirer la qdisc racine emporte avec elle toutes les qdiscs enfants, les classes et les filtres.
sudo tc qdisc del dev eth0 rootConfirmez ensuite que l’interface est revenue à son état par défaut :
sudo tc qdisc show dev eth0qdisc fq_codel 0: root refcnt 2 limit 10240p flows 1024 quantum 1514 target 5ms interval 100ms memory_limit 32Mb ecn drop_batch 64Si la ligne d’origine était autre chose que fq_codel ou noqueue, remettez-la explicitement : la suppression rétablit le défaut du noyau, pas nécessairement ce que votre distribution avait configuré.
Valider que ça fonctionne
Prenez une mesure de référence avant tout façonnage, puis répétez exactement la même mesure après. Sans elle, vous ne pouvez pas séparer l’apport de netem du comportement propre du chemin.
ping -c 5 203.0.113.45Référence sur un hôte voisin :
5 packets transmitted, 5 received, 0% packet loss, time 4006ms
rtt min/avg/max/mdev = 0.812/0.934/1.104/0.098 ms
Après netem delay 150ms 30ms loss 2% sur le même hôte, la même commande devrait montrer un temps aller-retour qui monte d’environ le délai configuré, un mdev qui grimpe près de la valeur de gigue, et de la perte visible sur une série plus longue :
5 packets transmitted, 5 received, 0% packet loss, time 4007ms
rtt min/avg/max/mdev = 121.4/150.8/179.2/19.7 ms
Une perte de 2 % a besoin de volume pour apparaître : lancez ping -c 500 -i 0.05 203.0.113.45 et lisez le pourcentage du sommaire au lieu de vous fier à cinq paquets.
Ensuite, confirmez que les paquets traversent bel et bien la qdisc netem. Les compteurs de statistiques donnent la réponse qui fait autorité :
sudo tc -s qdisc show dev eth0qdisc netem 8001: root refcnt 2 limit 1000 delay 150ms 30ms loss 2%
Sent 148320 bytes 1104 pkt (dropped 23, overlimits 0 requeues 0)
backlog 0b 0p requeues 0Un compteur Sent non nul et qui augmente prouve que votre trafic passe par cette qdisc ; dropped devrait suivre le pourcentage de perte configuré. Si Sent reste à zéro pendant le test, vous avez façonné la mauvaise interface ou votre filtre ne correspond à rien.
Enfin, mesurez la conséquence au niveau applicatif. Un test de débit montre l’effet sur les transferts en volume — voyez mesurer le débit avec iperf3 pour savoir lire sa sortie :
iperf3 -c 203.0.113.45 -t 10Pour la latence des requêtes, une décomposition des temps par curl est plus parlante que la bande passante brute :
curl -o /dev/null -s -w 'connect %{time_connect}s ttfb %{time_starttransfer}s total %{time_total}s\n' https://203.0.113.45/healthconnect 0.302s ttfb 0.461s total 0.478sLa poignée de main TCP coûte un aller-retour supplémentaire : time_connect devrait donc monter d’environ le délai configuré, signe net que le façonnage touche l’établissement de connexion, pas seulement les données.
Dépannage
RTNETLINK answers: No such file or directory sur tc qdisc add. Le module noyau sch_netem n’est pas chargé ou pas compilé. Lancez sudo modprobe sch_netem et confirmez avec lsmod | grep sch_netem. Sur les noyaux infonuagiques allégés, il peut être complètement absent de linux-image : installez linux-modules-extra-$(uname -r) sur Ubuntu. La même erreur apparaît si vous faites une faute de frappe dans le nom d’une qdisc.
RTNETLINK answers: File exists. Une qdisc occupe déjà cette position. Utilisez sudo tc qdisc replace dev eth0 root netem ... pour l’écraser, ou faites d’abord sudo tc qdisc del dev eth0 root. Ça arrive aussi quand une exécution précédente a laissé une racine prio ou htb derrière elle.
Vous vous êtes verrouillé hors de SSH. Appliquer une perte lourde ou un rate bas à root dégrade la sortie de votre propre session. Si vous joignez encore une console — console série infonuagique, terminal de l’hyperviseur, IPMI — lancez tc qdisc del dev eth0 root. Sinon, un redémarrage efface toutes les qdiscs, puisque rien de tout ça n’est persistant. Pour éviter la récidive : armez le coupe-circuit de l’étape 2 et restreignez avec un filtre comme à l’étape 9.
Le délai est appliqué mais ping ne bouge pas. C’est presque toujours la mauvaise interface. eth0 n’a rien d’universel : les configurations en agrégat, en pont et les instances infonuagiques utilisent souvent ens5, enp0s3 ou un pont. Tranchez avec ip route get 203.0.113.45 et réappliquez sur l’interface nommée dans le champ dev. Deux autres causes : le trafic vers un conteneur ou une machine virtuelle sur le même hôte peut ne jamais toucher la carte physique, et un ping vers une adresse locale reste sur lo, que netem sur eth0 ne voit jamais.
La perte ou le délai semble doublé. Vous avez façonné les deux hôtes, ou bien à la fois une interface physique et le veth ou le pont sur le même chemin. La perte se cumule : 5 % dans chaque sens donne environ 9,75 % de bout en bout. Le délai s’ajoute une fois par sens, donc 100 ms par hôte donne à peu près 200 ms de temps aller-retour. Décidez délibérément si vous modélisez un lien symétrique (façonnez les deux) ou asymétrique (façonnez-en un seul).
Le débit chute bien plus que le rate configuré. Le limit 1000 paquets par défaut de netem est un petit arriéré. Combinez un délai élevé et une charge élevée et la file déborde, ajoutant des pertes que vous n’avez jamais demandées. Montez-le avec limit 10000 et remesurez en surveillant le compteur dropped de tc -s qdisc show. Servez-vous de tcpdump pour capturer le trafic si vous devez voir les retransmissions directement.
Quand ce n’est pas la bonne approche
netem modélise le lien, pas le réseau. Il ne sait pas reproduire un équipement intermédiaire capricieux, un trou noir de MTU, un routage asymétrique, un résolveur DNS qui retourne parfois SERVFAIL, ou un répartiteur de charge qui coupe les connexions inactives. Ce sont pourtant ces pannes-là qui font tomber la production, et aucun réglage de qdisc ne les fera apparaître.
Il n’est pas persistant non plus. Chaque qdisc disparaît au redémarrage ou sur un ip link down/up — souhaitable pour une expérience, inadéquat comme mécanisme de contrainte. Un plafond de débit durable appartient à votre hyperviseur, aux contrôles de trafic de votre fournisseur infonuagique, ou à une unité systemd qui le réapplique volontairement.
La portée se limite à l’interface d’un seul hôte. Injecter des fautes dans un maillage de services complet ou dans une centaine de pods transforme netem en un gros paquet de scripts fragiles par nœud ; un contrôleur d’ingénierie du chaos qui gère les qdiscs pour vous convient mieux.
Enfin, les modèles de netem sont statistiques. loss gemodel approxime le caractère par rafales, mais la congestion réelle est corrélée au trafic réel d’une façon qu’un modèle aléatoire ne capturera pas. Servez-vous de netem pour savoir si vos délais d’expiration, vos réessais et vos disjoncteurs sont configurés sainement — pas pour certifier un comportement sur le lien d’un client précis. La référence qui fait autorité pour chaque paramètre est la page de manuel tc-netem, et la syntaxe des qdiscs à classes et des filtres est documentée dans tc(8).
Si c’est le genre de travail que vous préféreriez ne plus jamais porter, c’est le quotidien d’Opérations Cloud — réservez une revue d’infrastructure.