Le soutien WordPress entreprise est le contrat qui dit qui répare quoi, et à quelle vitesse, quand un site WordPress qui rapporte de l’argent tombe en panne. Si vous devez rédiger, réviser ou contester une telle entente, la plupart des désaccords avec un fournisseur se ramènent à quatre clauses. Elles portent sur ce qui est inclus, la façon de définir la sévérité, le chronomètre qui tourne à chaque étape d’escalade et la personne qui approuve un changement. Une promesse de temps de réponse ne couvre pas la réparation, alors un fournisseur peut accuser réception de votre billet en quinze minutes et laisser le paiement en panne pendant six heures. Rédigez ces clauses en termes que les deux parties peuvent observer, et faites tourner votre propre sonde de disponibilité pour qu’un incident contesté ait des horodatages plutôt que des souvenirs.
Ce que vous allez accomplir
- Repérer dans une entente la frontière de portée où commence « l’extension de votre développeur » — la cause la plus fréquente d’un billet enlisé.
- Rédiger des définitions de sévérité qu’un inconnu à 2 h peut appliquer sans vous appeler.
- Attribuer chaque tâche récurrente — mises à jour, correctifs, sauvegardes, restaurations, code sur mesure — à un seul responsable nommé.
- Monter une sonde indépendante de disponibilité et de latence depuis un second point de vue.
- Produire l’inventaire noyau, PHP et extensions que tout fournisseur compétent demande avant de cadrer.
Prérequis
- Une installation WordPress accessible en SSH avec WP-CLI disponible ;
wp --infodoit fonctionner. Sinon, les étapes d’inventaire ont des équivalents graphiques plus lents. curlsur une machine qui n’est pas votre hébergeur web. Un portable convient pour des vérifications ponctuelles, mais la sonde en cron doit vivre sur une petite instance dans un autre réseau, idéalement chez un autre fournisseur. Toute version de curl à partir de 7.29 possède les variables d’écriture utilisées ici.- L’accès à vos journaux web et d’erreurs PHP. Sur cPanel, c’est habituellement
~/logs; sur les serveurs de la famille Debian,/var/log/apache2ou/var/log/nginx. - L’entente de support, projet ou version en vigueur. Si on ne vous a jamais transmis de tableau de sévérité écrit, cette absence est déjà un constat.
Comment ça fonctionne
Une entente de support entreprise est une chaîne de passations, et chaque passation a son propre chronomètre. Savoir lequel tourne à quelle étape est ce qui permet d’écrire un engagement utile plutôt qu’un chiffre rassurant.
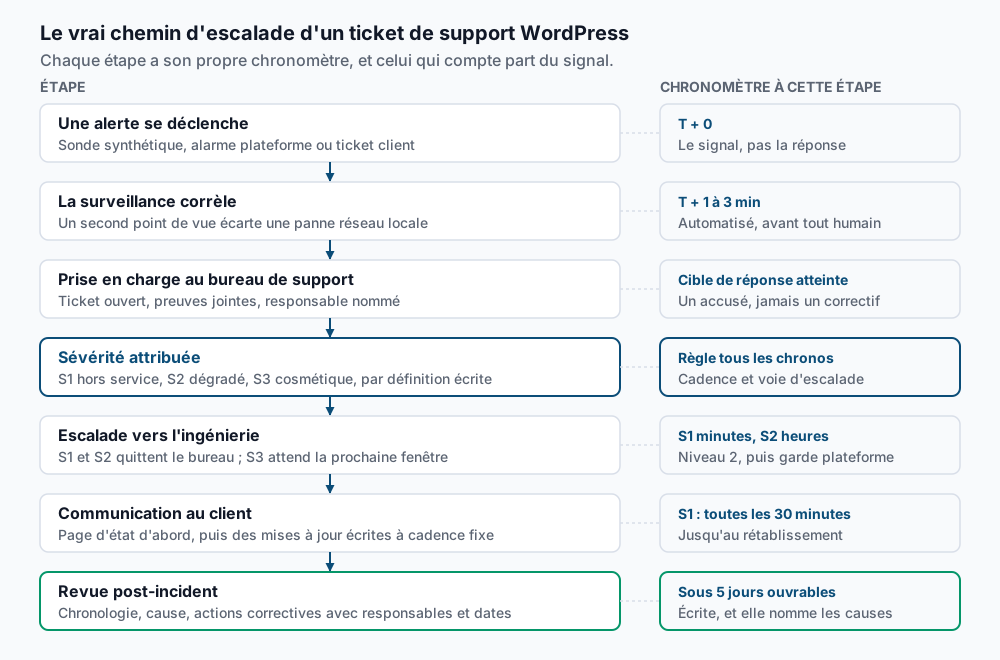
Trois éléments de cette chaîne sont régulièrement mal écrits.
Le premier, c’est le moment où le chronomètre démarre. Si l’entente dit « réponse en 15 minutes après la création du billet » et que les billets sont créés par un humain qui regarde un tableau de bord, le fournisseur contrôle l’heure de départ. Le chronomètre doit partir du signal d’alerte, et l’entente doit préciser que la surveillance ouvre le billet automatiquement.
Le deuxième, c’est ce qu’est une réponse. Un accusé de réception est une réponse ; ce n’est ni un diagnostic, ni un responsable, ni une estimation. Une bonne entente engage sur trois choses distinctes : l’accusé de réception, un responsable nommé avec une sévérité attribuée, et une cadence de mises à jour qui continue jusqu’au rétablissement du service. Le temps de résolution ne se contractualise généralement pas sur un système qui porte du code tiers, et le fournisseur qui s’y engage soit gonfle largement le chiffre, soit n’a pas lu son propre contrat.
Le troisième, c’est qui travaille réellement le billet. Un modèle réaliste a des niveaux : un bureau de support qui reçoit tout, reproduit, rassemble les preuves et ferme la majorité des billets à partir de runbooks ; un deuxième niveau qui détient tout ce qui touche la plateforme ; et une garde plateforme qu’on ne joint que lorsque la sévérité et le temps écoulé le commandent. Tout fournisseur qui laisse entendre qu’un ingénieur principal prend personnellement chaque billet décrit une entreprise incapable de survivre à son propre volume. Demandez plutôt quelle proportion de billets se ferme au premier niveau, et quel est le déclencheur d’escalade.
Les canaux comptent aussi. Le travail technique passe par le bureau de support et sa trace de billets, parce que c’est là que s’accumulent les preuves ; le numéro de téléphone que vous détenez est celui de votre gestionnaire de compte, pour l’escalade commerciale. Confondre les deux, c’est ainsi qu’un problème critique devient un message vocal que personne n’horodate.
Ce que le contrat doit cadrer
Les disputes de portée sont la raison pour laquelle les billets stagnent. Avant de discuter des temps de réponse, réglez la matrice ci-dessous : chaque ligne a besoin d’un seul responsable, et les deux parties doivent avoir lu la même version.
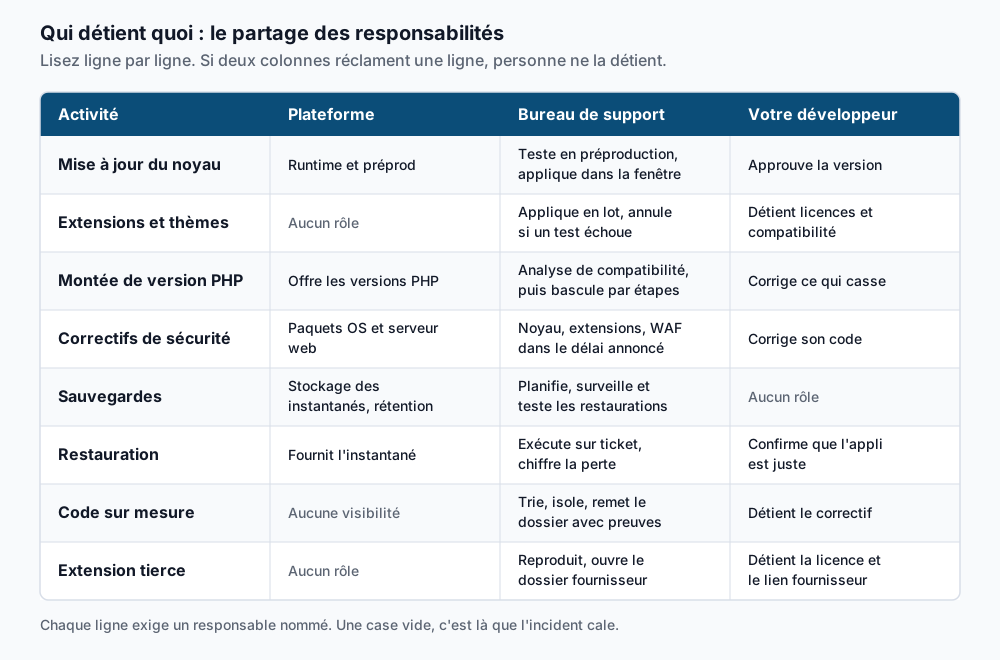
La frontière qui fait vraiment mal, c’est le code sur mesure. Un fournisseur peut raisonnablement s’engager sur le tri — reproduire la panne, l’isoler à une extension ou à un thème, remettre une trace d’appels et une reproduction — mais pas à corriger du code qu’il n’a pas écrit et ne peut pas tester. Exigez que la remise soit documentée : le billet nomme le fichier, le hook et la requête qui déclenche le problème, plutôt que « conflit d’extension tierce, voyez votre développeur ». En échange, vous fournissez un propriétaire joignable pour ce code. Une extension maison dont l’auteur a quitté l’agence il y a deux ans est une dépendance orpheline, et l’entente doit vous forcer à nommer quelqu’un pour chacune.
La gestion du changement mérite ses propres clauses. Au minimum : une fenêtre de maintenance avec un fuseau horaire ; qui approuve un saut de version du noyau et où cette approbation est consignée ; si les versions mineures du noyau sont appliquées automatiquement et les majeures retenues ; le plan de retour arrière par catégorie de changement, y compris le point où le retour arrière l’emporte sur la correction en avant ; et une voie d’urgence pour un correctif de sécurité qui ne peut pas attendre, avec notification rétroactive au lieu d’approbation préalable. Un changement qu’on ne peut pas annuler est une migration, et sa place est dans un projet, pas dans une fenêtre.
Sévérité, et pourquoi réponse n’est pas résolution
Les définitions de sévérité échouent quand elles sont écrites en fonction du niveau d’énervement de quelqu’un. Écrivez-les en état observable, pour que la personne au bureau à 2 h classe comme vous l’auriez fait.
| Sévérité | Définition | Cadence des mises à jour | Escalade |
|---|---|---|---|
| S1 | Site injoignable, paiement ou connexion en échec pour tous, ou données à risque | Toutes les 30 minutes jusqu’au rétablissement | Immédiate vers le deuxième niveau |
| S2 | Dégradé : une section cassée, temps de réponse en multiples de la référence, un mode de paiement en échec | Toutes les 2 heures en heures ouvrables | Deuxième niveau si non résolu au bureau après 60 minutes |
| S3 | Cosmétique ou touchant un seul utilisateur, contournement existant, sans impact sur les revenus | Quotidienne | Prochaine fenêtre de maintenance |
Deux détails rendent ceci utilisable. La sévérité doit s’attribuer à partir de preuves visibles des deux côtés — « en multiples de la référence » ne veut rien dire si aucune référence n’est enregistrée quelque part. Et elle doit bouger dans un seul sens sans discussion : le client peut hausser la sévérité, le fournisseur ne peut la baisser qu’avec une raison écrite au billet. Sans cette asymétrie, chaque désaccord devient une négociation pendant que le site est à terre.
Pas à pas
1. Montez votre propre sonde de disponibilité depuis un second point de vue. Exécutez ceci sur une petite instance qui n’est ni votre hébergeur web, ni sur le même réseau.
mkdir -p ~/uptime
cat > ~/uptime/probe.sh <<'EOF'
#!/bin/sh
URL="https://example.com/"
STAMP=$(date -u +%Y-%m-%dT%H:%M:%SZ)
RESULT=$(curl -sS -o /dev/null -m 15 -A "acme-uptime-probe/1.0" \
  -w '%{http_code} %{time_namelookup} %{time_connect} %{time_appconnect} %{time_starttransfer} %{time_total}' \
  "$URL" 2>&1)
echo "$STAMP $RESULT" >> "$HOME/uptime/probe.log"
EOF
chmod +x ~/uptime/probe.sh
~/uptime/probe.sh && tail -n 1 ~/uptime/probe.log
Sortie attendue — une ligne, six champs après l’horodatage :
2026-09-09T14:02:01Z 200 0.004316 0.020901 0.058442 0.214883 0.2210042. Planifiez-la chaque minute et conservez le journal. Utilisez un chemin absolu ; cron ne lit pas votre profil de shell.
( crontab -l 2>/dev/null; echo "* * * * * /home/deploy/uptime/probe.sh" ) | crontab -
crontab -l | tail -n 1
Sortie attendue :
* * * * * /home/deploy/uptime/probe.shRemplacez /home/deploy par votre propre chemin. wc -l ~/uptime/probe.log doit monter d’une ligne par minute.
3. Capturez une ventilation de temps à joindre à un billet. Quand quelqu’un dit « le site est lent », ceci transforme l’impression en chiffre et désigne une couche.
cat > ~/curl-timing.txt <<'EOF'
     dns:  %{time_namelookup}s
 connect:  %{time_connect}s
     tls:  %{time_appconnect}s
    ttfb:  %{time_starttransfer}s
   total:  %{time_total}s
    code:  %{http_code}
EOF
curl -sS -o /dev/null -w "@$HOME/curl-timing.txt" https://example.com/
Sortie attendue :
     dns:  0.004316s
 connect:  0.020901s
     tls:  0.058442s
    ttfb:  0.214883s
   total:  0.221004s
    code:  200
Lisez-la comme une soustraction : le TTFB moins le temps TLS, c’est ce que l’origine a réellement passé à réfléchir. Si cet écart est de 1,8 seconde alors que la connexion prend 0,02, le réseau va bien et le billet porte sur PHP ou la base de données — un billet très différent de celui où time_connect est lent.
4. Produisez l’inventaire que le fournisseur va demander. Exécutez ceci depuis la racine WordPress.
wp core version --extraSortie attendue :
WordPress version: 6.6.2
Database revision: 57155
TinyMCE version:   4.9110 (49110-20201110)
Package language:  en_US
Puis la liste des extensions, dans un format lisible par un humain comme par un tableur :
wp plugin list --format=csv --fields=name,status,version,update,update_versionSortie attendue :
name,status,version,update,update_version
akismet,active,5.3.7,none,
woocommerce,active,9.1.4,available,9.2.2
acme-custom-shipping,active,1.0.0,none,
Tout ce que vous ne reconnaissez pas dans cette liste, ou dont la version n’a pas bougé depuis deux ans, est une ligne qui a besoin d’un responsable nommé avant toute signature.
5. Regroupez le tout dans un artefact daté.
{ echo "## core";    wp core version --extra
  echo "## php";     php -v | head -n 1
  echo "## plugins"; wp plugin list --format=csv --fields=name,status,version,update
  echo "## themes";  wp theme list --format=csv --fields=name,status,version
} > "inventory-$(date -u +%F).txt"
wc -l "inventory-$(date -u +%F).txt"
Sortie attendue :
64 inventory-2026-09-09.txt6. Vérifiez combien de temps survivent vos preuves. Une revue écrite cinq jours plus tard ne vaut rien si les journaux ont tourné après deux.
ls -lt ~/logs/ 2>/dev/null | head -n 4Sortie attendue sur un hébergement de type cPanel :
total 48920
-rw-r----- 1 deploy deploy 12093440 Sep  9 14:05 example.com-ssl_log
-rw-r----- 1 deploy deploy   903214 Sep  9 14:05 example.com
-rw-r----- 1 deploy deploy  4210338 Sep  1 00:12 example.com-Aug-2026.gz
Sur un serveur que vous administrez, lisez la politique de rotation directement :
grep -E 'daily|weekly|monthly|rotate' /etc/logrotate.d/apache2Sortie attendue :
	daily
	rotate 14
Cela fait 14 jours de journaux web. Comparez à l’échéance de revue post-incident de votre entente : une revue due en 10 jours ouvrables contre 14 jours civils de journaux ne laisse presque aucune marge. Le correctif est une clause obligeant le fournisseur à figer les journaux pertinents à l’ouverture de l’incident.
7. Confirmez que la page d’état n’est pas hébergée dans ce qui tombe.
curl -sS -o /dev/null -w '%{remote_ip} %{http_code}\n' https://status.example.com/
curl -sS -o /dev/null -w '%{remote_ip} %{http_code}\n' https://example.com/
Sortie attendue — deux adresses différentes :
104.18.22.7 200
198.51.100.24 200
Si les deux se résolvent dans la même infrastructure, la page d’état sera indisponible pendant exactement l’incident où vous en aviez besoin.
Validez que ça fonctionne
Simulez la trace de preuves de bout en bout. Mettez le site hors service volontairement pendant votre propre fenêtre de maintenance — mettre en pause un pool PHP-FPM suffit — et confirmez que chaque maillon s’est déclenché.
grep -c ' 200 ' ~/uptime/probe.log
awk '$2 != 200 {print}' ~/uptime/probe.log | tail -n 5
Sortie attendue — le compte des vérifications saines, puis les échecs avec leurs horodatages :
1438
2026-09-09T21:14:01Z 000 0.004102 0.021044 0.000000 0.000000 15.001233
2026-09-09T21:15:01Z 503 0.004310 0.020880 0.058221 0.881003 0.882117
Un code HTTP 000 avec un total proche de votre valeur -m est un dépassement de délai, pas une 5xx — la distinction compte, parce que les deux pointent vers des couches différentes.
Vérifiez ensuite le côté humain contre ces horodatages : une alerte a atteint la surveillance du fournisseur, un billet existe avec une sévérité attribuée, et la première mise à jour est arrivée dans la cadence annoncée. Chaque maillon qui ne s’est pas déclenché est une clause à renégocier. Répétez l’exercice pour une restauration, en suivant vérifier qu’une sauvegarde WordPress est vraiment restaurable — un chemin de restauration jamais testé est la clause la plus susceptible de lâcher la nuit où on en a besoin.
Les questions à poser, et les réponses qui alertent
- « Quelle proportion de billets se ferme au premier niveau, et qu’est-ce qui déclenche l’escalade ? » Un chiffre et un déclencheur, c’est une bonne réponse. « Tout va directement à un ingénieur principal » est un signal d’alarme : ni couche de tri, ni runbooks.
- « Montrez-moi une revue post-incident caviardée du dernier trimestre. » Une vraie contient une chronologie minute par minute, une cause, et des actions correctives avec responsables et dates. Un texte qui se termine par « désolés pour le désagrément » est un signal d’alarme.
- « Qui approuve un saut de version du noyau, et où est-ce consigné ? » Si la réponse est « on vous tient au courant », personne ne détient le retour arrière.
- « Combien de temps conservez-vous les journaux, et les figez-vous à l’ouverture d’un incident ? » Le flou ici annonce une dispute sans preuves plus tard.
- « Que se passe-t-il quand la panne vient d’une extension que nous avons payée ? » Vous voulez le tri plus un dossier ouvert chez le fournisseur, et une mention claire que la licence vous appartient.
- Tout fournisseur qui promet qu’aucune panne ne surviendra, ou qui cite une certification de conformité sans nommer l’entité de la chaîne d’approvisionnement qui la détient réellement, fait du marketing, pas des opérations.
Dépannage
La sonde en cron n’écrit rien. Cron s’exécute dans un environnement minimal. Confirmez que la tâche a bien tourné avec grep CRON /var/log/syslog | tail, puis vérifiez que curl et date se résolvent — utilisez des chemins absolus comme /usr/bin/curl dans le script sinon.
La sonde signale des pannes que le site n’a jamais eues. Un WAF ou une règle anti-robot la bloque. C’est pourquoi le script pose -A "acme-uptime-probe/1.0" : donnez à la sonde une identité stable, faites-la ajouter à la liste d’autorisation, et ne laissez jamais une vérification se cacher derrière un agent de navigateur.
wp dit que ceci ne semble pas être une installation WordPress. Vous n’êtes pas dans la racine. Passez-la explicitement : wp core version --path=/home/deploy/public_html. En multisite, ajoutez --url= pour tout ce qui est propre à un site.
time_appconnect vaut 0.000000 sur une URL HTTPS. Vous êtes redirigé avant la fin de la négociation TLS, ou vous avez sondé l’URL en HTTP simple. Sondez l’URL canonique exacte, et n’ajoutez -L que si vous voulez délibérément mesurer toute la chaîne de redirections plutôt qu’un seul saut.
Vos temps sont bons et les gens se plaignent encore. Un seul curl mesure une requête non mise en cache depuis un seul réseau. Répétez depuis une seconde région, et vérifiez si le chemin lent est le trafic connecté qui contourne le cache de pages — un autre diagnostic, qui relève de la forme préproduction vers production plutôt que du contrat de support. Chaque variable d’écriture utilisée plus haut est documentée dans le manuel de curl.
Quand ce n’est pas la bonne approche
Un modèle de support formel a un coût réel — tableaux de sévérité, fenêtres, approbations, revues — et il n’est pas gratuit à opérer de votre côté non plus. Pour un site vitrine à faible trafic où deux heures d’interruption ne coûtent rien de mesurable, une simple entente d’entretien est la réponse honnête, et une clause S1 relève du théâtre.
C’est aussi le mauvais instrument si vous exploitez déjà votre propre rotation de garde avec des gens qui connaissent l’application ; ce qu’il vous faut alors, c’est une escalade vers la couche plateforme, pas un bureau qui double votre tri.
Et aucun contrat ne compense une architecture qui résiste à l’exploitation : aucun tableau de sévérité ne répare un site sans environnement de préproduction, sans chemin de retour arrière et avec une seule copie non versionnée de la production. Ce sont des propriétés de plateforme et non des clauses, à prouver chez un hébergeur candidat avant même de rédiger l’entente — les vérifications sont dans les exigences d’un hébergement WordPress d’entreprise. Réglez d’abord l’exploitabilité, puis rédigez l’entente autour. Et ne laissez jamais la clause de sauvegarde d’un fournisseur tenir lieu de votre propre restauration vérifiée : la clause décrit une obligation, votre test de restauration décrit la réalité.
Un WordPress qui rapporte vraiment mérite un opérateur — Stack Harbor opère cette pile sous WordPress Entreprise ; réservez une consultation d’infrastructure.