La plateforme Stack Harbor PaaS met à l’échelle selon deux axes indépendants — vertical (redimensionnement d’un conteneur en place en ajustant son plafond de cloudlets) et horizontal (modification du nombre de nœuds dans une couche) — et propose une couche d’auto-clustering qui transforme un service mononœud en grappe de production en un seul interrupteur depuis l’assistant de topologie (Topology Wizard). Cette page cadre l’ensemble de la section mise à l’échelle et clustering.
Ce que couvre cette page
- Les deux axes de mise à l’échelle et leur composition.
- Les déclencheurs manuels et automatiques pour chaque axe.
- L’auto-clustering : ce que la plateforme configure quand vous activez l’interrupteur.
- Le clustering propre aux bases de données pour MariaDB/MySQL/Percona, PostgreSQL et MongoDB.
- Multi-régions et protection contre la bascule, et où chaque sujet se trouve dans cette section.
Les deux axes
Mise à l’échelle verticale — redimensionner le conteneur
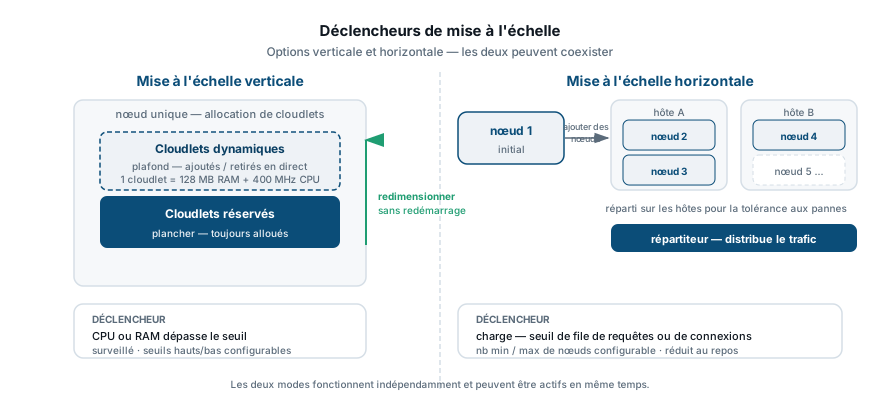
Chaque conteneur de la plateforme se voit allouer des ressources en cloudlets, l’unité de RAM et de CPU de la plateforme. Chaque conteneur possède deux valeurs de cloudlets : un plancher réservé (toujours disponible, toujours facturé) et un plafond dynamique (consommé et libéré selon la charge, facturé à la consommation réelle). La mise à l’échelle verticale consiste à déplacer ce plafond. Vous l’augmentez pour donner plus de marge à un conteneur ; vous le réduisez pour limiter la consommation de ressources. La plateforme ajuste l’allocation sur place — le conteneur continue de fonctionner. En mode de mise à l’échelle verticale automatique, la plateforme suit la consommation en direct et ajuste l’allocation en continu dans la plage que vous définissez, de sorte que vous payez approximativement ce que le processus consomme réellement plutôt qu’une réservation fixe. Consultez Mise à l’échelle verticale automatique pour la logique des déclencheurs et la configuration.
Mise à l’échelle horizontale — modifier le nombre de nœuds
Une couche est le groupe de nœuds qui assure un rôle dans votre environnement : vos serveurs d’application, vos réplicas de base de données, vos nœuds de cache. La mise à l’échelle horizontale modifie le nombre de nœuds que contient cette couche.
La mise à l’échelle horizontale manuelle déplace un curseur dans le panneau de topologie : vous choisissez un nombre, la plateforme provisionne ou retire des nœuds et redistribue le trafic. Les nouveaux nœuds sont placés sur des hôtes matériels distincts selon les règles d’anti-affinité de la plateforme, de sorte qu’une panne sur un seul hôte ne peut pas emporter toute la couche.
La mise à l’échelle horizontale automatique se déclenche sur des seuils de charge configurables. Vous définissez des seuils — CPU, mémoire, débit réseau, E/S disque ou IOPS — et la plateforme ajoute des nœuds quand le seuil supérieur est maintenu pendant une durée configurable, puis les retire quand la charge passe sous le seuil inférieur pendant une autre durée. Consultez Mise à l’échelle horizontale automatique pour la configuration des déclencheurs.
Chaque couche possède également un mode de mise à l’échelle qui détermine comment les nouveaux nœuds sont créés :
- Stateless — les nouveaux nœuds sont construits à partir du gabarit d’image de base. La valeur par défaut adéquate pour la plupart des couches de serveurs d’application.
- Stateful — les nouveaux nœuds sont clonés depuis le conteneur maître en cours, préservant toute configuration appliquée après le provisionnement initial. Utile lorsqu’une pile stocke de la configuration sur le disque qui n’est pas capturée dans l’image.
La plateforme choisit un mode par défaut selon le type de pile ; vous pouvez le remplacer depuis le Topology Wizard.
Auto-clustering
L’auto-clustering transforme une pile mononœud en grappe de production depuis le Topology Wizard — un seul interrupteur, sans câblage manuel de la réplication. Lorsque vous l’activez, la plateforme configure la réplication, élit ou désigne un nœud primaire, ajoute le nombre approprié de nœuds réplicas et provisionne un proxy de point d’entrée là où la topologie de la pile l’exige. Lorsque vous mettez à l’échelle la couche horizontalement après avoir activé l’auto-clustering, la plateforme joint automatiquement chaque nouveau nœud à la grappe et le retire proprement lors de la réduction.
Les piles prises en charge comprennent Tomcat/TomEE, GlassFish, Payara, Jenkins, WildFly, MySQL, MariaDB, Percona, PostgreSQL, MongoDB, Couchbase, Redis, OpenSearch et le conteneur de stockage partagé.
La page Qu’est-ce que l’auto-clustering explique le concept et quand l’activer. La page Auto-clustering via le Topology Wizard couvre en détail les piles prises en charge, les modes de grappe et les propriétés JPS pour les solutions packagées.
Auto-clustering des bases de données
Les paliers base de données disposent de flux d’auto-clustering dédiés, car les schémas de réplication, les couches de proxy et les modes de bascule diffèrent substantiellement selon les moteurs :
- MariaDB, MySQL, Percona — ProxySQL comme point d’entrée, réplication primaire-secondaire ou Galera. Voir Auto-clustering MariaDB/MySQL/Percona.
- PostgreSQL — réplication primaire-secondaire avec Pgpool-II ; prend en charge la bascule automatique et manuelle. Voir Auto-clustering PostgreSQL.
- MongoDB — replica sets avec les temporisations d’élection par défaut ; chaînes de connexion qui survivent à une bascule sans modification côté client. Voir Auto-clustering MongoDB.
Protection contre la bascule
Le module additionnel Traffic Distributor exécute un module de contrôle de santé intégré qui surveille les nœuds selon un intervalle configurable. Il retire un nœud défaillant de la table de routage sans attendre un nouvel événement de mise à l’échelle horizontale et le réintègre automatiquement dès sa récupération. Cela est distinct de la gestion d’appartenance propre à l’auto-clustering : la protection contre la bascule opère au niveau du répartiteur de charge et s’applique à toute couche, qu’elle soit groupée ou non. Voir Protection contre la bascule.
Combiner les deux axes
Les deux axes de mise à l’échelle sont indépendants et peuvent être actifs simultanément sur la même couche. Un schéma courant : définir un plafond de cloudlets généreux pour absorber les pics CPU courts sans ajouter de nœuds (vertical), et configurer le scale-out horizontal seulement quand une charge soutenue atteint régulièrement ce plafond. La plateforme réconcilie l’état déclaré ; vous n’avez pas à coordonner les deux mécanismes manuellement.
La suite
- Mise à l’échelle horizontale — scale-out et scale-in manuels, mode stateless vs. stateful, particularités par pile.
- Mise à l’échelle horizontale automatique — configuration des déclencheurs de charge : seuils, périodes de refroidissement et surveillance.
- Mise à l’échelle verticale automatique — cloudlets, allocation réservée vs. dynamique, et l’ajustement des ressources en temps réel.
- Qu’est-ce que l’auto-clustering — quand activer l’auto-clustering et ce que la plateforme configure derrière l’interrupteur.
- Auto-clustering via le Topology Wizard — piles prises en charge, modes de grappe et propriétés JPS.
- Auto-clustering MariaDB/MySQL/Percona — point d’entrée ProxySQL et schémas de réplication.
- Auto-clustering PostgreSQL — Pgpool-II, réplication primaire-secondaire et bascule.
- Auto-clustering MongoDB — replica sets, temporisations d’élection et chaînes de connexion.
- Protection contre la bascule — contrôles de santé sous le module Traffic Distributor.
- Mise à l’échelle par CLI — changetopology — scripter les deux axes depuis le CLI de la plateforme.